⚡ Quarkus : le Java supersonique pensé pour le cloud
📚 Introduction
« Supersonic Subatomic Java ». Le slogan de Quarkus est un peu grandiloquent, mais il annonce bien la couleur : un framework Java pensé pour démarrer vite, consommer peu et vivre dans des conteneurs.
Quarkus est né chez Red Hat en 2019 et a rejoint la Commonhaus Foundation en septembre 2024, aux côtés d’Hibernate et de Jackson. Version courante au moment où j’écris : Quarkus 3.39.5, sortie le 24 septembre 2026, avec deux branches LTS maintenues en parallèle (3.27 et 3.33).
Si vous avez fait du Java côté serveur, vous connaissez probablement Spring Boot. Je m’en servirai comme point de repère tout au long de l’article, parce que c’est la façon la plus rapide de comprendre ce que Quarkus fait autrement. Et si vous venez de PHP, mon article sur Spring Boot, Symfony et Laravel montre que ces frameworks partagent la même architecture. Quarkus aussi.
🚀 Démarrer en trois commandes
Le CLI s’installe via JBang ou SDKMAN :
sdk install quarkus
quarkus create && cd code-with-quarkus
quarkus dev
Pour Quarkus 3, il faut un JDK 17 ou plus. L’équipe a annoncé que Quarkus 4 passera à Java 21 minimum, avec une première RC prévue fin septembre 2026. La raison principale : les threads virtuels, qu’elle veut utiliser sans contorsions par réflexion.
Le projet généré contient une ressource REST. Aucune annotation propriétaire, c’est du Jakarta REST standard :
@Path("/hello")
public class GreetingResource {

	@Inject
	GreetingService service;

	@GET
	@Produces(MediaType.TEXT_PLAIN)
	public String hello() {
		return service.greet();
	}
}
Le champ service est en visibilité package. C’est voulu, j’y reviens plus bas.
🔍 Qu’est-ce qui rend Quarkus différent ?
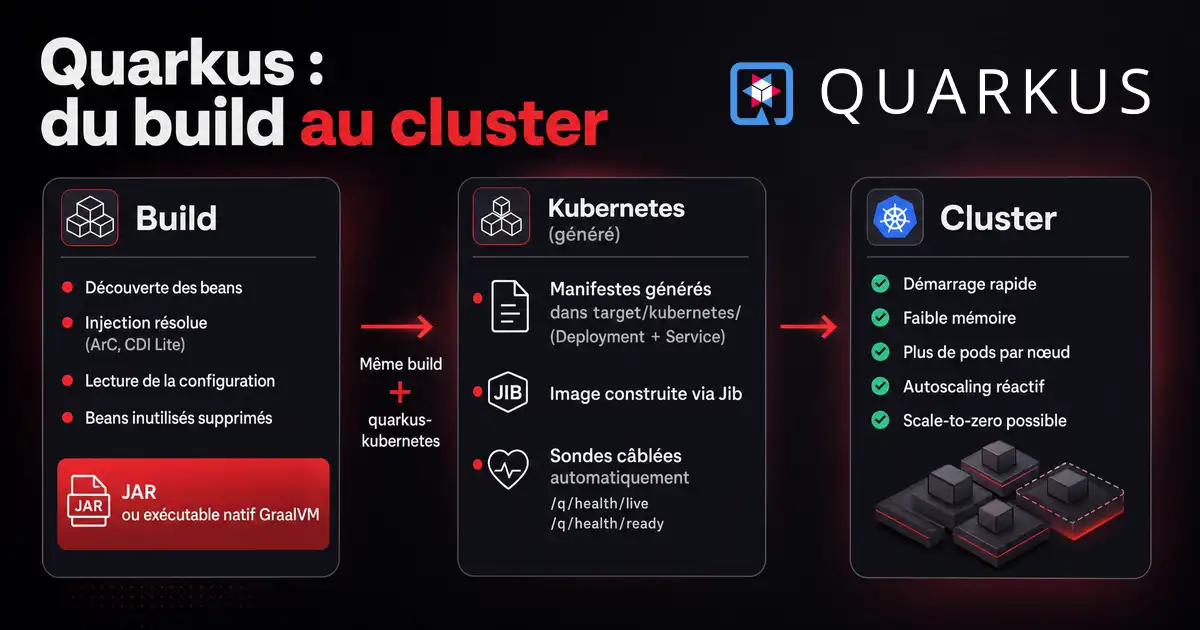
Le build. Quarkus exécute au moment de la compilation ce que les autres frameworks font à chaque lancement, et n’embarque dans l’artefact que le résultat.
La comparaison avec Spring Boot rend l’idée concrète. Au démarrage, Spring Boot scanne le classpath, évalue les conditions de son auto-configuration et construit son contexte. Ce travail est refait à chaque lancement de l’application. Quarkus le fait une fois, pendant le build Maven ou Gradle : le JAR produit sait déjà quels beans existent, qui injecte quoi et quelle configuration s’applique. Au démarrage, il ne reste presque rien à faire.
Son conteneur d’injection, ArC, implémente CDI Lite (et passe le TCK correspondant). La découverte des beans et la résolution des dépendances se font au build, et ArC supprime par défaut les beans que personne n’utilise. Une injection ambiguë ou insatisfaite fait échouer la compilation au lieu de faire tomber l’application au démarrage.
Ce modèle a un prix, et la doc le dit franchement. ArC n’implémente pas CDI Full, et les portable extensions CDI ne sont pas supportées : elles supposent de modifier le graphe au runtime, précisément ce que Quarkus s’interdit. Même logique pour le private : pour injecter un membre privé, ArC doit passer par la réflexion, ce qui alourdit l’exécutable natif. D’où la recommandation d’utiliser la visibilité package.
Ce même principe rend la compilation native GraalVM presque naturelle. Une commande suffit :
./mvnw install -DnativeSpring Boot sait aussi compiler en natif depuis sa version 3, mais sa doc liste les renoncements : classpath figé, @Profile limité, @ConditionalOnProperty non supporté. Chez Quarkus, ces contraintes sont celles de tous les jours, donc passer au natif ne change presque rien au code.
🧩 Panache et les standards
Côté persistance, Panache simplifie Hibernate ORM avec deux styles au choix, Active Record ou repository :
@ApplicationScoped
public class PersonRepository implements PanacheRepository<Person> {

	public Person findByName(String name) {
		return find("name", name).firstResult();
	}

	public List<Person> findAlive() {
		return list("status", Status.Alive);
	}
}
Là où Spring Data JPA dérive les requêtes du nom des méthodes, Panache fournit des raccourcis (find, list, count, delete) qu’on appelle explicitement. Et le style Active Record (extends PanacheEntity, méthodes statiques sur l’entité) rappelle franchement Eloquent.
Le reste de la pile s’appuie sur des spécifications publiques : CDI pour l’injection, Jakarta REST pour le web, MicroProfile pour la santé ou la configuration. Un développeur Jakarta EE s’y retrouve tout de suite. Un développeur Spring doit apprendre de nouvelles annotations, pas de nouveaux concepts.
🧰 La boucle de développement
C’est là que Quarkus m’a le plus convaincu. quarkus dev lance l’application en live coding : on modifie une classe, on rafraîchit, le changement est pris en compte sans redémarrage manuel. Appuyez sur r dans le terminal et les tests continus démarrent. Quarkus sait quels tests couvrent quel code, et ne relance que ceux concernés par la modification.
Les Dev Services complètent le tableau. Ajoutez l’extension PostgreSQL sans configurer d’URL de connexion : en dev et en test, Quarkus démarre un conteneur (via Testcontainers) et y branche l’application. Kafka, Redis, Keycloak, RabbitMQ, MongoDB fonctionnent pareil. Il suffit d’un Docker ou d’un Podman, et quarkus.devservices.enabled=false coupe tout.
Spring Boot propose l’équivalent avec son support Docker Compose ou Testcontainers au dev, mais il faut le déclarer. Quarkus le déduit de l’absence de configuration.
☁️ Pourquoi dit-on que Quarkus est cloud first ?
Parce qu’il a été conçu dès le départ pour les conteneurs et Kubernetes.
Sur un serveur qui tourne des mois, un démarrage de quelques secondes ne gêne personne. En Kubernetes, le calcul change. Chaque pod qui redémarre, chaque réplique ajoutée par l’autoscaler, chaque déploiement progressif paie ce démarrage. Et la mémoire réservée par pod se multiplie par le nombre de répliques puis par le nombre de services. Un framework qui démarre vite et consomme peu, c’est plus de pods par nœud, un autoscaling qui réagit avant que la charge soit passée, et une facture cloud plus légère. En serverless ou en scale-to-zero, le démarrage devient carrément le temps de réponse de la première requête.
Le build-time de Quarkus attaque ces deux coûts à la racine, et le natif les pousse plus loin. Mais l’orientation cloud se voit aussi dans l’outillage. Avec l’extension quarkus-kubernetes, chaque build génère les manifestes dans target/kubernetes/ (un Deployment et un Service par défaut), et quarkus.kubernetes.deploy=true les applique directement au cluster. Des extensions dédiées ciblent OpenShift, Knative, Minikube ou Kind. L’image se construit dans le même geste, via Jib, Docker, Podman ou Buildpacks :
quarkus ext add kubernetes container-image-jib smallrye-health
./mvnw install -Dquarkus.kubernetes.deploy=true
Ajoutez smallrye-health et les sondes suivent : /q/health/live, /q/health/ready et /q/health/started sont exposées, et les probes liveness et readiness sont câblées automatiquement dans le Deployment généré. Côté serverless, quarkus-amazon-lambda-http déploie une application Quarkus REST existante derrière API Gateway, en JAR ou en natif pour réduire le démarrage à froid.
Pour situer : Spring Boot active lui aussi ses sondes Actuator quand il détecte Kubernetes, et sait produire une image via Buildpacks. Les manifestes, en revanche, restent à votre charge. Spring Boot s’intègre très bien au cloud ; Quarkus part du principe qu’il y vit.
🧭 Venir de Spring Boot
Pour ceux qui ont Spring en tête, voici la correspondance des briques courantes :
| Spring Boot | Quarkus |
|---|---|
@Service, @Autowired | @ApplicationScoped, @Inject (CDI) |
@RestController, @GetMapping | @Path, @GET (Jakarta REST) |
| Spring Data JPA | Hibernate ORM + Panache |
application.properties, profils | application.properties, profils %dev |
| Actuator health | SmallRye Health (/q/health) |
| Docker Compose au dev | Dev Services |
mvn -Pnative native:compile | ./mvnw install -Dnative |
Et pour une migration en douceur, Quarkus propose des extensions de compatibilité : quarkus-spring-di, Spring Web, Spring Data JPA. @Autowired, @Service, @GetMapping sont compris. Attention toutefois : aucun contexte Spring n’est démarré, les annotations sont lues comme métadonnées et traduites vers ArC. C’est une passerelle, pratique pour tester Quarkus sur du code existant.
⚠️ Quelques précautions
Le natif coûte au build. La doc parle de « quelques minutes » de compilation contre quelques secondes en JVM, et de 4 à 8 Go de RAM sur la machine de build. Sur une CI modeste, ça se sent. -Dquarkus.native.container-build=true évite d’installer GraalVM localement, pas de payer ce temps.
Toutes les bibliothèques Java ne sont pas compatibles natif. Réflexion, proxies dynamiques, chargement de classes au runtime : il faut des extensions Quarkus ou des hints. Avant de promettre du natif, vérifiez que chaque dépendance a son extension.
Méfiez-vous du CDI.current(). Un bean récupéré programmatiquement n’apparaît pas comme utilisé au build, et ArC peut le supprimer. On le marque @Unremovable ou on ajuste la suppression des beans.
L’écosystème est plus petit. Spring Security, Spring Batch ou Spring Cloud n’ont pas toujours d’équivalent aussi complet, et on trouve moins de réponses toutes faites en ligne. À vérifier avant de s’engager si votre projet en dépend.
Le natif n’est pas obligatoire. Quarkus en mode JVM démarre déjà vite et reste un très bon framework. Beaucoup d’équipes s’arrêtent là, et c’est un choix raisonnable.
🎉 Conclusion
Quarkus n’invente pas une nouvelle architecture. On y retrouve le contrôleur, le service injecté et le repository, comme partout. Ce qu’il change, c’est le moment où le framework fait son travail. Ce déplacement vers le build se paie en contraintes, mais il rapporte là où le cloud facture : le démarrage, la mémoire, la densité de pods.
Ajoutez à ça la boucle de développement la plus agréable que j’aie vue en Java et un outillage Kubernetes intégré, et Quarkus devient mon premier réflexe pour un nouveau service Java destiné aux conteneurs. Spring Boot garde l’avantage de son écosystème, et une équipe qui le maîtrise n’a pas de raison urgente d’en changer.
🔗 Liens utiles
- Site officiel Quarkus
- Quarkus — démarrer
- Guide ArC — injection de dépendances
- Hibernate ORM avec Panache
- Dev Services
- Tests continus
- Compiler un exécutable natif
- Déployer sur Kubernetes
- SmallRye Health — sondes de santé
- AWS Lambda avec Quarkus REST
- Compatibilité Spring DI
- Java 21, socle de Quarkus 4
- Annonce Quarkus 3.39.5
- Dépôt GitHub
quarkusio/quarkus - Spring Boot — images natives GraalVM
/faq
Questions fréquentes
Qu'est-ce que Quarkus ?
+
Un framework Java open source, lancé en 2019 et aujourd'hui hébergé par la Commonhaus Foundation. Il s'appuie sur les standards Jakarta (CDI, Jakarta REST, JPA) et effectue au build l'essentiel du travail qu'un framework classique fait au démarrage : découverte des beans, résolution de l'injection, lecture de la configuration.
Pourquoi Quarkus est-il qualifié de cloud first ?
+
Parce qu'il vise d'abord les conteneurs et Kubernetes : démarrage rapide et faible empreinte mémoire grâce au build-time et au natif, manifestes Kubernetes générés au build, sondes liveness et readiness câblées automatiquement avec SmallRye Health, et extensions pour Knative, OpenShift ou AWS Lambda.
Quarkus est-il facile à prendre en main quand on vient de Spring Boot ?
+
Oui : on retrouve l'injection de dépendances, les contrôleurs REST et les repositories, sous des annotations Jakarta au lieu d'annotations Spring. Des extensions comme quarkus-spring-di ou Spring Web comprennent même les annotations Spring, sans démarrer de contexte Spring.
Quelle version de Java faut-il pour Quarkus ?
+
Java 17 au minimum pour Quarkus 3. L'équipe a annoncé que Quarkus 4 exigera Java 21, notamment pour les threads virtuels.