🔥 Superphenix : un cloud complet sur ton propre matériel
📚 Introduction
Depuis le rachat de VMware par Broadcom, beaucoup d’équipes infra font le même calcul : les licences grimpent, le matériel reste le même, et la dépendance à un éditeur unique devient un risque business. Les alternatives existent. Proxmox VE couvre très bien la virtualisation, KubeVirt fait entrer les VMs dans Kubernetes. Mais il manque souvent la couche au-dessus : le multi-tenant, les VPC, les quotas, une console, du Kubernetes as a Service pour les clients.
C’est exactement le trou que veut combler Superphenix. Le projet vient d’être ouvert sous licence Apache 2.0, et il ne sort pas d’un labo. Il est né des besoins d’un opérateur cloud en production, et il fait aujourd’hui tourner le cloud public d’Agora Calycé, un CSP français. Il est maintenu par Rayshift, l’entreprise de l’équipe qui l’a conçu.
🔍 Qu’est-ce que Superphenix, concrètement ?
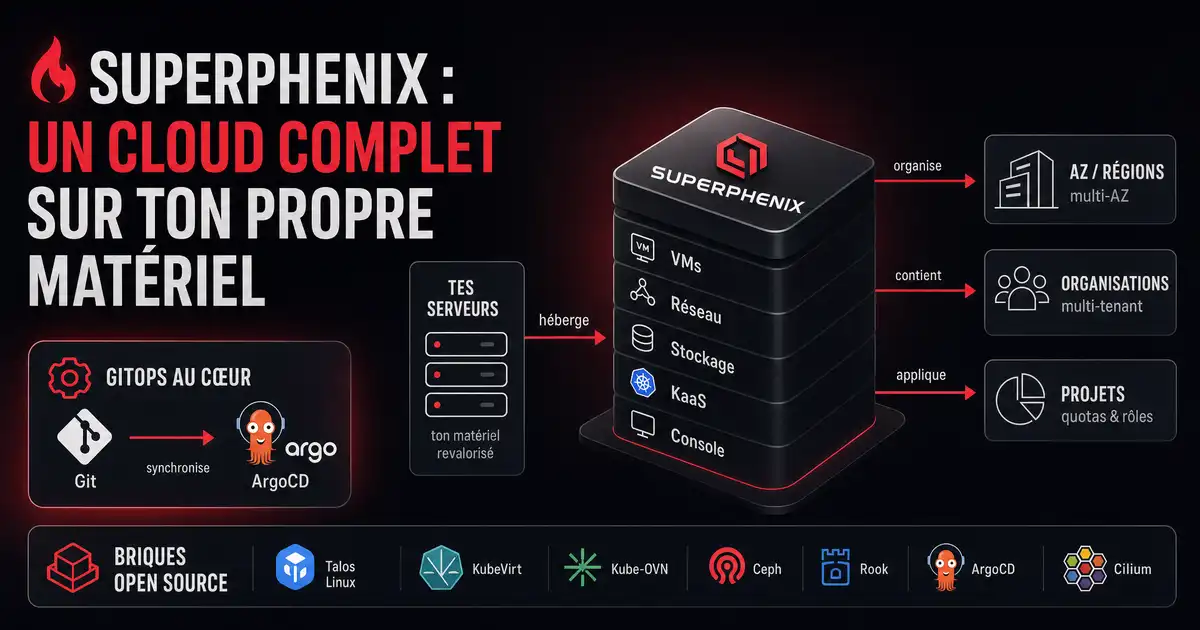
Une stack cloud complète à poser sur tes propres serveurs. Kubernetes y joue le rôle de plan de contrôle, et tout le reste (machines virtuelles, disques, réseaux, clusters Kubernetes clients) devient une ressource gérée par ce plan.
Le README résume l’offre par couches :
| Couche | Ce qui est fourni |
|---|---|
| Hyperviseur | VMs avec migration à chaud, snapshots, autoscaling des noeuds |
| Stockage | Bloc, fichier et objet compatible S3, avec réplication et reprise |
| Réseau | VPC, NAT gateways, BGP, load balancers, QoS, security groups |
| PaaS | Kubernetes as a Service pour les clusters des tenants |
| SaaS | Services prêts à l’emploi (annoncés, pas encore livrés) |
| Console | Interface web multi-tenant couvrant toutes les AZ et régions |
| Cycle de vie | Installation, mises à jour et provisionnement pilotés en GitOps |
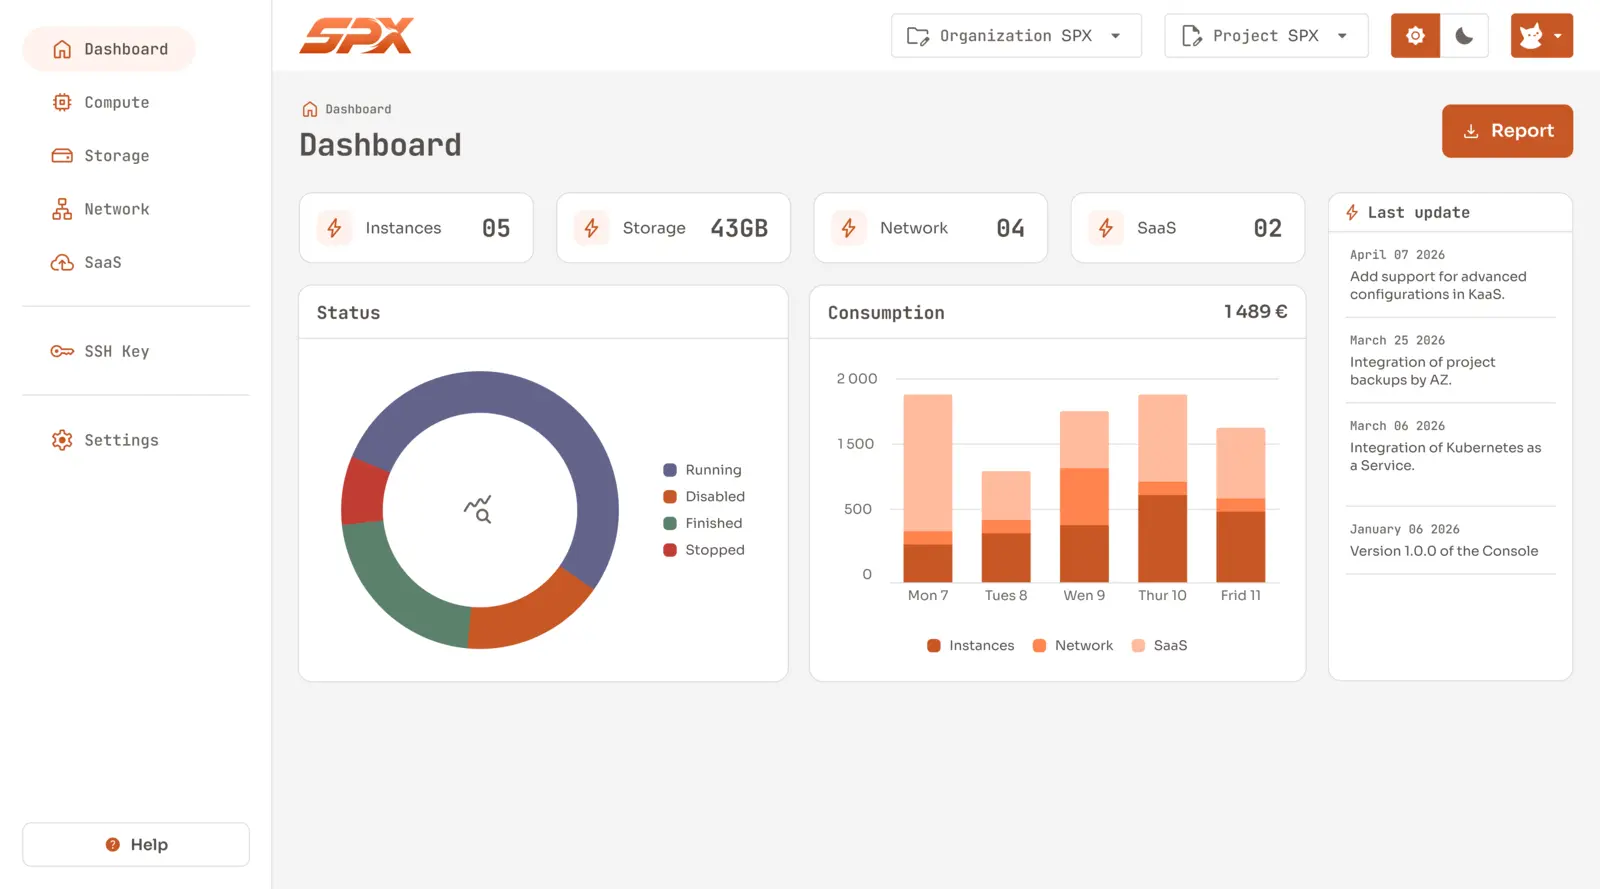
Ce qui me plaît, c’est le choix de ne rien réinventer. Superphenix assemble des projets CNCF et open source que je connais et en qui j’ai confiance, puis ajoute la couche produit qui leur manque.
🧱 Une architecture bâtie sur des briques connues
Sous le capot, la documentation cite des projets solides :
- Talos Linux pour l’OS des noeuds. C’est la seule base officiellement supportée.
- KubeVirt pour faire tourner les instances : chaque VM est une ressource Kubernetes, comme je le détaille dans mon article sur KubeVirt.
- Kube-OVN, Multus CNI et Cilium pour le réseau software-defined (VPC, subnets, elastic IPs).
- Ceph, orchestré par Rook, pour le stockage bloc et objet.
- ArgoCD pour synchroniser la stack, dans la logique que je décrivais pour ArgoCD sur k3s.
Empilées, ces briques forment des couches nettes. Talos et Kubernetes en bas, les projets open source au milieu, et en haut les services qu’un tenant consomme depuis la console :
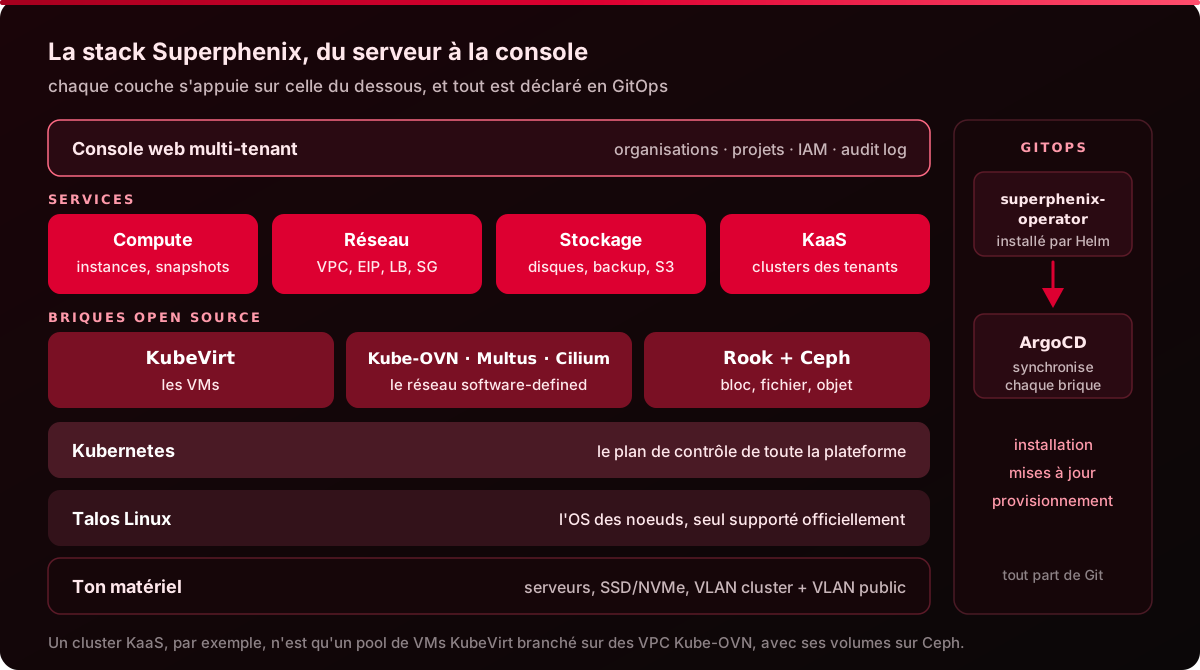
Le modèle d’organisation reprend celui des clouds publics. Un cluster Superphenix est un cluster Kubernetes. Plusieurs clusters forment une zone de disponibilité (AZ), qui sert de domaine de panne. Les AZ se regroupent en régions, une simple étiquette d’organisation. Côté clients, deux niveaux : des organisations qui contiennent des projets, et c’est au niveau du projet que s’appliquent les rôles et les quotas. Un même projet peut avoir des VMs dans plusieurs AZ.
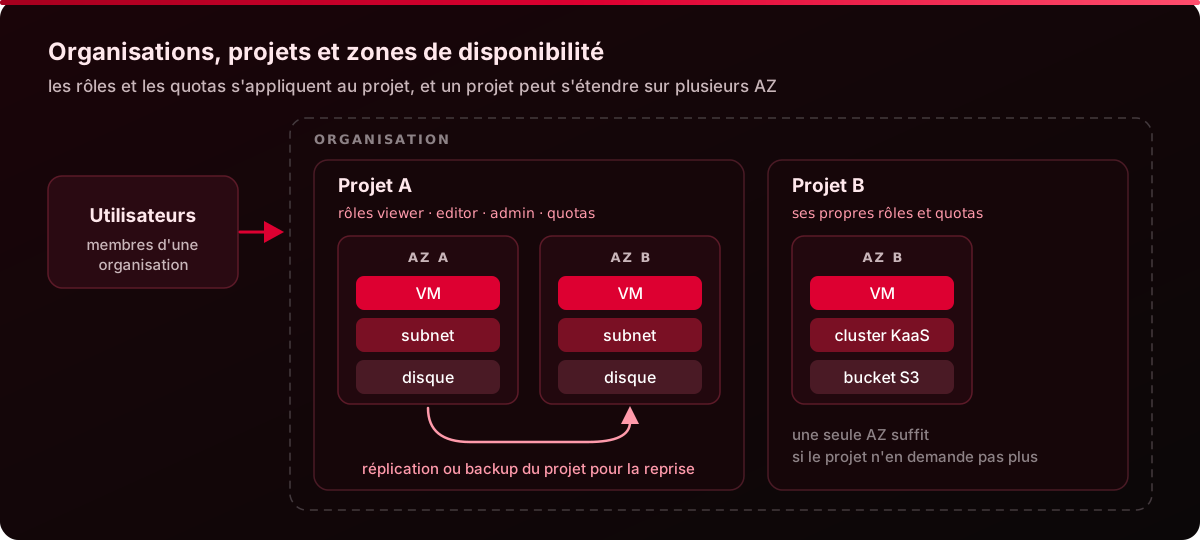
La doc précise un point que j’apprécie : une AZ étirée sur plusieurs datacenters n’a de sens qu’avec environ 2 ms de latence aller-retour entre sites, ou moins. En pratique, deux salles d’un même campus ou deux points de présence dans la même métropole. Au-delà, il vaut mieux créer des AZ séparées.
🧩 Hyperconvergé ou découplé : quel mode choisir ?
Hyperconvergé pour démarrer et grandir en ajoutant des serveurs, découplé quand la performance ou le partage du stockage priment. Le choix se fait AZ par AZ, avant l’installation.
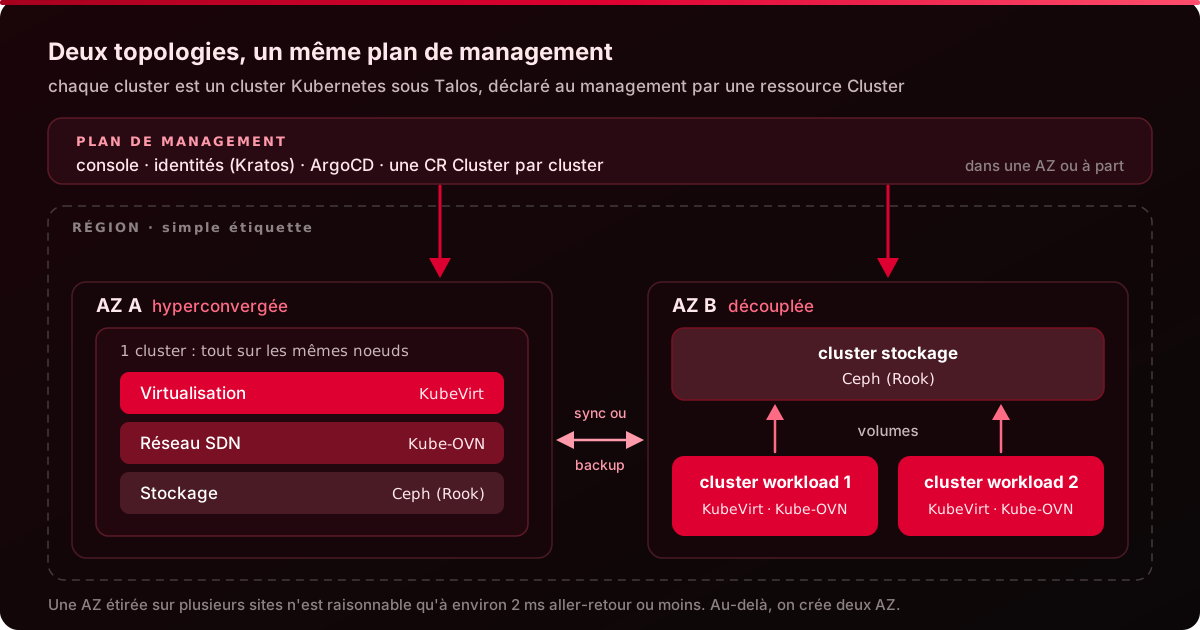
Le mode hyperconvergé
Stockage et calcul partagent les mêmes noeuds, dans un seul cluster. Chaque serveur apporte à la fois ses disques à Ceph et son CPU à KubeVirt. C’est le modèle le plus simple à installer et à maintenir, et le moins cher, puisque le matériel est mutualisé. Pour grandir, on ajoute des serveurs et la capacité de stockage suit celle de calcul.
Le revers, c’est la contention. Ceph et les VMs se disputent les mêmes CPU, la même RAM et le même réseau, surtout pendant une reconstruction après une panne de disque. La doc le recommande pour les preuves de concept, les déploiements à une seule AZ et les équipes qui veulent croître horizontalement. C’est aussi le mode du lab de démarrage.
Le mode découplé
Le stockage vit sur des clusters dédiés, les VMs sur d’autres clusters « workload » qui consomment ces volumes. Chaque cluster est déclaré avec deploymentTopology: Decoupled et un type qui vaut Storage ou Workload. Plusieurs clusters workload, dans des racks ou des sites différents, peuvent se brancher sur le même stockage.
Il faut deux fois plus de clusters, donc plus de matériel et plus d’exploitation. En échange, chaque tier a son matériel, on dimensionne stockage et calcul séparément, et rien ne se marche dessus. C’est le mode que la doc conseille en production pour les environnements chargés ou quand il faut une frontière de sécurité nette entre stockage et calcul. Il facilite aussi le partage du stockage entre plusieurs AZ : des AZ hyperconvergées voisines peuvent consommer le stockage l’une de l’autre, mais seulement si la latence et le réseau le permettent. Et c’est le mode que la doc retient pour partager le stockage avec des systèmes extérieurs, comme un cluster VMware en cours de migration.
| Critère | Hyperconvergé | Découplé |
|---|---|---|
| Installation et maintenance | simples, un cluster | plus lourdes, deux fois plus de clusters |
| Coût | faible, matériel mutualisé | plus élevé, matériel dédié par tier |
| Montée en charge | on ajoute des serveurs, tout grandit | stockage et calcul grandissent séparément |
| Performance | ressources partagées | matériel dédié, sans contention |
| Stockage partagé | en général un stockage par AZ | un même stockage pour plusieurs AZ ou systèmes |
Et le plan de management ?
Un second choix se combine au premier : où tourne le plan de management (console, GitOps, installation et mises à jour). Il peut vivre dans une AZ, sur le même cluster que les workloads, ce qui est simple mais fait de cette AZ un point de défaillance unique si elle en pilote d’autres. Ou à part, sur un cluster dédié qui peut même tourner chez un autre fournisseur : plus de travail, mais un point neutre pour orchestrer plusieurs AZ et basculer plus facilement. La doc le conseille dès qu’on passe à plusieurs AZ.
Les deux choix donnent quatre combinaisons. La plus simple, « fully integrated », met tout sur un cluster. La plus robuste, « fully decoupled », sépare stockage, calcul et management. Une précision qui compte : on peut mélanger des AZ hyperconvergées et découplées sous le même management, mais on ne peut pas passer une AZ d’un mode à l’autre après coup. La doc qualifie ce chemin de non supporté. Déplacer le plan de management, en revanche, reste une procédure prévue.
🛠️ Ce qu’on peut en faire
Côté compute, une instance va de 1 à 32 vCPU et de 1 à 64 Go de RAM, avec BIOS ou UEFI, Secure Boot, vTPM 2.0, cloud-init, et une console série ou VNC dans le navigateur. Le stockage gère disques, snapshots copy-on-write, politiques de sauvegarde et réplication asynchrone entre zones, plus un stockage objet S3.
La partie la plus intéressante pour moi reste le KaaS. Un tenant crée son cluster Kubernetes, dont les noeuds sont des pools de VMs branchés sur ses VPC, avec CNI et CSI intégrés à la plateforme. Les workers se migrent à chaud comme n’importe quelle instance, et chaque version de Superphenix supporte trois versions mineures de Kubernetes. Pour un hébergeur, c’est l’offre « Kubernetes managé » sans dépendre d’un hyperscaler.
🚀 Installer un premier lab
Le guide officiel part du cas le plus simple : 3 noeuds, une AZ, en hyperconvergé, le management sur le même cluster, un switch et un VLAN à plat. Il te faut talosctl, Helm, kubectl et curl, une plage IPv4 réservée aux NAT gateways et aux elastic IPs, et un nom de domaine pour la console (nip.io dépanne en lab).
On démarre les noeuds sous Talos, puis on génère leur configuration :
talosctl gen config spx-local https://<api-endpoint>:6443Le controlplane.yaml généré ne convient pas tel quel : il faut l’éditer avant de l’appliquer. Superphenix installe lui-même le CNI et CoreDNS, et ce lab à 3 noeuds fait aussi tourner les workloads sur les control planes. Le cœur des changements :
cluster:
  allowSchedulingOnControlPlanes: true
  network:
    cni:
      name: none
  coreDNS:
    disabled: true
Le guide ajoute d’autres réglages indispensables : les sous-réseaux pods et services, le feature gate MutatingAdmissionPolicy sur l’API server et le controller manager, le module noyau openvswitch et une interface externe nommée ext0 sur chaque noeud. Copie le fichier complet depuis le guide de démarrage plutôt que de le réécrire, puis applique-le et initialise le cluster :
talosctl apply-config --insecure --nodes <node-ip> --file controlplane.yaml
talosctl bootstrap --nodes <first-control-plane-ip>
talosctl kubeconfig .
kubectl get nodes
Puis on déploie l’opérateur via son chart OCI, avec un values.yaml qui décrit la topologie, les domaines et le subnet externe :
OPERATOR_VERSION="$(curl -fsSL -o /dev/null -w '%{url_effective}' https://github.com/super-phenix/superphenix/releases/latest | sed 's#.*/v##')"
helm install superphenix-operator \
	"oci://ghcr.io/super-phenix/charts/superphenix-operator:${OPERATOR_VERSION}" \
	--namespace superphenix-system \
	--create-namespace \
	-f values.yaml
L’opérateur installe ensuite ArgoCD, qui synchronise le reste de la stack.
🎯 Qui l’utilise déjà ?
Le dépôt tient un fichier ADOPTERS.md qui répond noir sur blanc. Trois organisations y figurent aujourd’hui :
| Organisation | Type | Usage déclaré |
|---|---|---|
| Rayshift | Éditeur | L’entreprise où Superphenix a été créé, qui en assure le support entreprise |
| Agora Calycé | Utilisateur | CSP français qui s’appuie sur Superphenix pour son infrastructure de cloud public |
| Kercia | Utilisateur | Spécialiste français du vote électronique, qui en a fait sa plateforme de cloud privé principale |
La liste est courte, et c’est normal pour un projet qui vient d’ouvrir son code. Elle couvre pourtant les deux usages visés par le README : un opérateur qui vend du cloud public à ses clients, et une entreprise qui héberge ses propres applications critiques sur un cloud privé. Le vote électronique n’est pas le métier où l’on choisit sa plateforme à la légère.
Le fichier est aussi une porte d’entrée : si tu fais tourner Superphenix, une pull request suffit pour t’y ajouter.
🏢 Et Rayshift dans tout ça ?
Superphenix reste open source et auto-hébergeable par défaut. Rayshift, fondée par les créateurs du projet, vend la version industrialisée : releases qualifiées, support avec SLA, réponse aux incidents, réversibilité contractuelle, et accompagnement sur la migration depuis VMware, la conformité ou le réseau avancé. La cible affichée, ce sont les MSP et opérateurs cloud européens.
Le modèle me paraît sain. Un projet d’infrastructure critique a besoin d’une entreprise qui en vit, et le fait que le cœur soit sous Apache 2.0 limite le risque de se retrouver enfermé à nouveau.
⚠️ Quelques précautions
- Projet jeune en open source. La doc le dit elle-même : elle est encore en construction. Prévois de lire les sources et de passer sur le Slack.
- Talos, et pas n’importe quelle version. Le guide exige Talos 1.12.6 ou antérieur : les versions plus récentes touchent un bug du noyau Linux qui casse le SDN.
- NAT gateway et noeud hôte. À cause d’une limite de macvlan, le trafic d’une NAT gateway vers une adresse du noeud qui l’héberge est perdu. Mets un load balancer devant les noeuds plutôt que de pointer le DNS de la console sur un seul.
- Ceph a ses exigences. En hyperconvergé, dimensionne les machines pour Ceph plus l’hyperviseur, avec de la marge pour la reconstruction. Sur des disques lents, la doc propose
local-path, réservé au debug. - Le SaaS n’est pas encore là. Le DBaaS et les services prêts à l’emploi sont annoncés « soon ».
🎉 Conclusion
Superphenix ne remplace pas Proxmox pour un homelab de deux machines. Si tu veux un vrai cloud multi-tenant, avec VPC, quotas, KaaS et GitOps, sur ton matériel et sans licence propriétaire, c’est le projet le plus complet que je connaisse dans ce créneau. Il s’appuie sur KubeVirt, Ceph et Kube-OVN plutôt que sur du code maison.
Je te conseille de monter le lab à 3 noeuds pour te faire une idée, puis de regarder du côté de Rayshift si tu vises la production sur des charges critiques.
🔗 Liens utiles
/faq
Questions fréquentes
Qu'est-ce que Superphenix ?
+
Superphenix est une plateforme open source sous licence Apache 2.0 pour construire son propre cloud (IaaS, PaaS, puis SaaS) sur son matériel. Kubernetes sert de plan de contrôle, et les VMs, le stockage, le réseau et les services managés tournent comme des charges de premier plan au-dessus.
Sur quelles briques open source repose Superphenix ?
+
D'après la documentation officielle : Talos Linux pour l'OS des noeuds, KubeVirt pour les machines virtuelles, Kube-OVN, Multus et Cilium pour le réseau, Ceph piloté par Rook pour le stockage, et ArgoCD pour le déploiement GitOps.
Quel est le rôle de Rayshift dans Superphenix ?
+
Rayshift est l'entreprise créée par l'équipe qui a construit Superphenix. Elle propose une version commerciale avec des releases qualifiées, du support avec SLA, de l'aide à la migration depuis VMware et de l'accompagnement à la mise en production. Le projet open source reste utilisable sans elle.
Superphenix hyperconvergé ou découplé, lequel choisir ?
+
L'hyperconvergé met stockage Ceph et VMs sur les mêmes noeuds : simple, peu coûteux, idéal pour un PoC ou une AZ unique. Le découplé sépare un cluster de stockage et des clusters workload : plus lourd, mais plus performant, et il facilite le partage du stockage entre plusieurs AZ. Le choix se fait par AZ, avant l'installation, car passer de l'un à l'autre n'est pas supporté.
Qui utilise Superphenix en production ?
+
Le fichier ADOPTERS.md du dépôt cite Agora Calycé, un CSP français qui s'appuie sur Superphenix pour son cloud public, et Kercia, spécialiste du vote électronique, qui en a fait sa plateforme de cloud privé principale. Rayshift y figure comme éditeur.
Quel matériel faut-il pour tester Superphenix ?
+
Le guide de démarrage décrit un lab de 3 noeuds en topologie hyperconvergée, une seule zone de disponibilité, sur un switch et un VLAN à plat, avec une plage IPv4 réservée aux NAT gateways et aux elastic IPs.