🪨 Caveman : faire parler Claude Code en homme des cavernes, ça économise vraiment ?
📚 Introduction
Je passe une bonne partie de mes journées dans Claude Code, et une partie de ce qu’il m’écrit, je ne le lis pas. « Je vais d’abord regarder le fichier… », « Voici un récapitulatif de ce que j’ai fait… ». Ces phrases se paient au token, et elles occupent l’écran.
Caveman est parti de ce constat, sous forme de blague, en avril 2026 : faire parler l’agent comme un homme des cavernes. Slogan : « why many token when few do trick ». Le projet est passé premier sur Hacker News, puis il est devenu une société, passée par Y Combinator (batch Fall 2026). La version 4.1.0 est sortie le 8 novembre 2026. Le dépôt contient désormais bien plus qu’un prompt : une CLI, un proxy, un compresseur de contexte, et même un agent desktop pour Mac, Caveman Code.
La question qui m’intéresse est simple. Sur une vraie session de dev, combien ça fait gagner ?
🔍 Qu’est-ce que fait Caveman, concrètement ?
Deux choses distinctes : réduire ce que l’agent écrit, et réduire ce qu’il lit. La documentation du projet le dit elle-même : le skill ne compresse ni l’entrée, ni le contexte, ni les tokens de réflexion du modèle.
Le skill, c’est un fichier SKILL.md qui commence par :
Respond terse like smart caveman. All technical substance stay. Only fluff die.Derrière la blague, les règles sont précises : la réponse d’abord, pas de « Sure! » ni de « Let me », des phrases de 20 mots maximum calquées sur ASD-STE100 (l’anglais contrôlé des manuels de maintenance aéronautique). Les articles peuvent sauter, jamais les négations : « Never drop not/never/no/only/except ». Le code, les chemins et les messages d’erreur restent au caractère près. Et il y a une liste de cas où l’agent doit repasser en phrases complètes : alerte de sécurité, action irréversible, utilisateur qui repose la même question, et tout ce qui sort du chat (commits, commentaires, docs, PR).
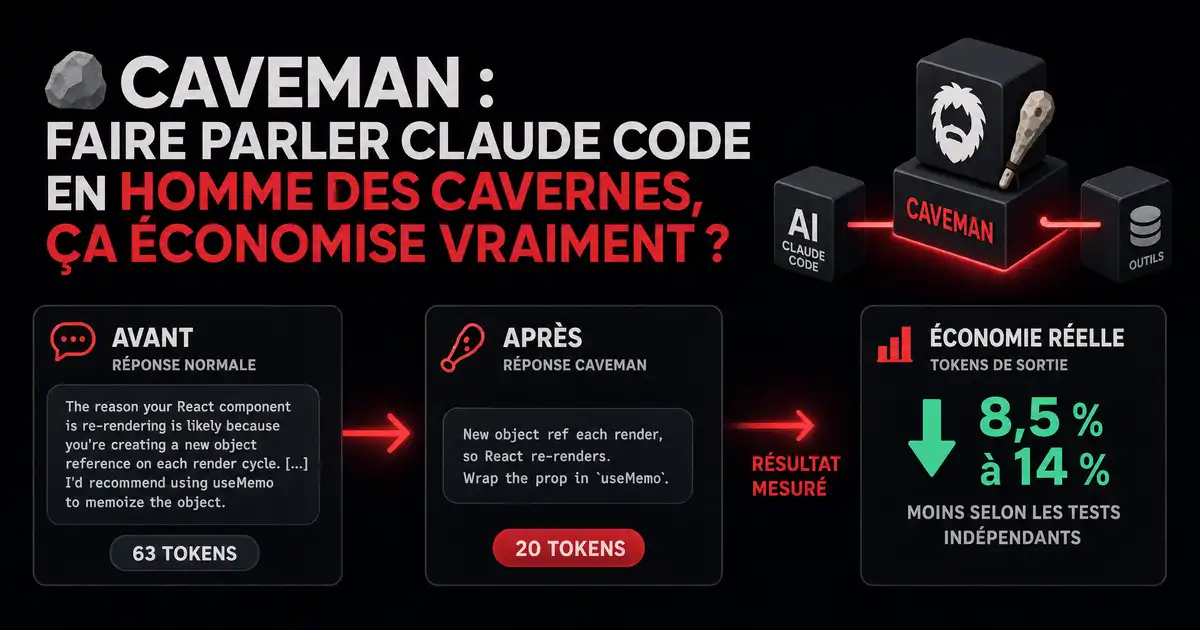
L’exemple du README résume l’idée. Réponse normale, 63 tokens :
The reason your React component is re-rendering is likely because you’re creating a new object reference on each render cycle. […] I’d recommend using useMemo to memoize the object.
Réponse Caveman, 20 tokens :
New object ref each render, so React re-renders. Wrap the prop in
useMemo.
Il existe trois niveaux : /caveman, /ultracave (encore plus sec) et /megacave, qui répond en chinois classique (文言文). Son propre SKILL.md reconnaît que le gain en tokens y est « small and noisy » : moins de caractères à l’écran, surtout. Une curiosité.
🧱 Skill ou proxy : deux installations différentes
Le skill seul s’installe avec :
npx skills add JuliusBrussee/caveman -gOn tape /caveman s’il ne démarre pas tout seul, stop caveman pour revenir à la normale. Sous Claude Code, la route plugin le charge à chaque session, sous-agents compris :
claude plugin marketplace add JuliusBrussee/caveman && claude plugin install caveman@cavemanLa CLI, elle, installe tout le reste :
npx @caveman-ai/cli@latestElle demande Node.js 22.13+, détecte vos agents et active six « rocks » : la voix, la compression d’entrée, un routeur de modèles (Auto, qui demande un compte), des scripts réutilisables (Blocks), un rapport sur vos dépenses de tokens et un navigateur compressé. caveman status liste ce qui tourne, caveman off browse coupe un module.
Le cœur, c’est le proxy local. Il écoute sur la boucle locale, l’agent lui envoie ses requêtes au lieu de les envoyer au fournisseur, et il compresse au passage les gros résultats d’outils : logs, CSV, JSON, sortie de tests. L’original est stocké sur disque avec un identifiant, et l’agent peut le redemander. C’est la même famille d’idée que Laravel PAO, mais appliquée à la requête entière, quel que soit l’outil.
Le projet publie son propre benchmark sur cette partie :
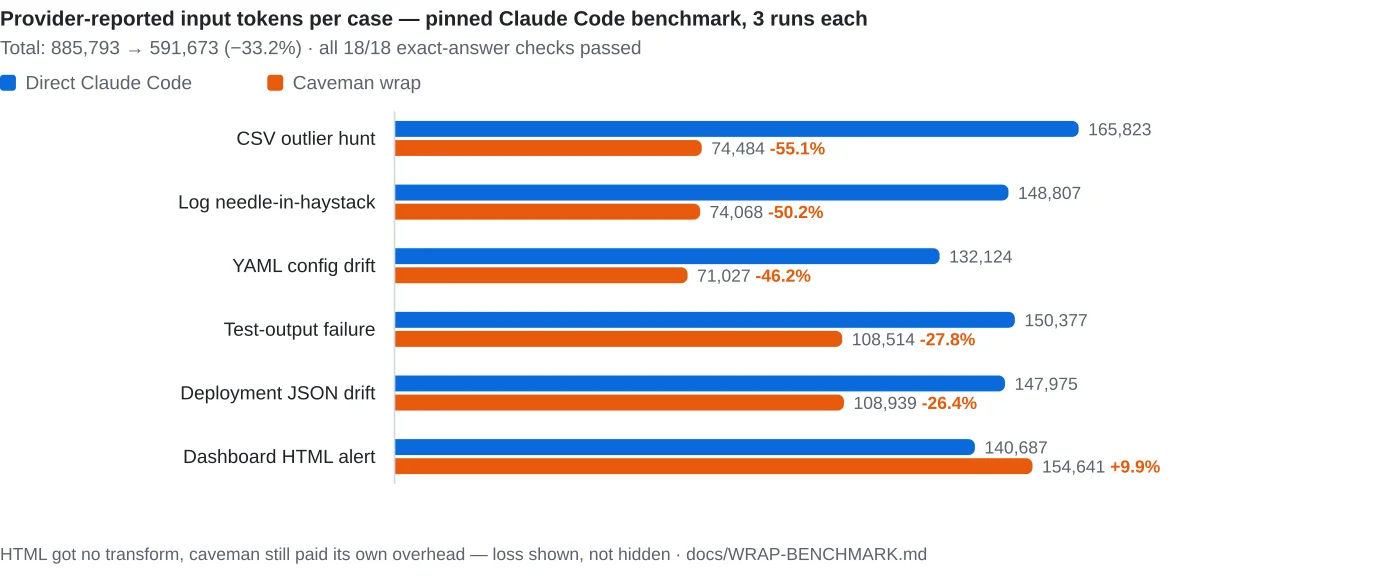
Benchmark publié par le projet (docs/assets du dépôt) : 33,2 % de tokens d’entrée en moins sur six cas, et une perte sur le HTML, qui n’a pas encore de compresseur.
Deux réserves que le README formule lui-même : ce run date d’août 2026 sur un moteur plus ancien, et chaque fichier de test cache un seul enregistrement utile dans 61 à 72 Ko de bruit. C’est le cas idéal pour un compresseur. Sur un projet Laravel où l’agent lit surtout des fichiers PHP, l’écart sera plus faible.
📊 Ce qu’on gagne réellement
Les premières versions affichaient « 65 % de tokens de sortie économisés ». Le README actuel ne le dit plus, et une page HONEST-NUMBERS.md explique pourquoi : d’anciennes versions de caveman-stats appliquaient un ratio fixe de 65 % sans mesure validée derrière.
Les mesures indépendantes vont toutes dans le même sens. JetBrains a lancé 86 tâches de SkillsBench avec Claude Code, skill activé de force : 8,5 % de tokens de sortie en moins, présenté comme un plafond. Nathan Cavaglione trouve 14 % de sortie et 12 % de coût en moins sur 92 tâches SWE-bench Pro avec Haiku 4.5, et constate que la sortie a augmenté sur un tiers des tâches. Un test cité dans la page du projet (300 runs par bras) relève 44,1 % de sortie en moins… pour un coût total qui bouge de +0,06 %.
Côté qualité, rien d’alarmant : chez JetBrains, les scores des deux bras sont statistiquement indiscernables (p = 0,82), et chez Cavaglione l’écart de taux de résolution (90,2 % contre 93,5 %) n’est pas significatif à cette taille d’échantillon.
Ce dernier chiffre résume tout. Dans une session d’agent, la sortie est petite à côté de l’entrée : le prompt système, l’historique et les résultats d’outils sont renvoyés à chaque tour, en grande partie via le cache. Le skill coûte lui-même environ 1 160 tokens d’entrée selon le README. Face à une simple consigne « Answer concisely. », le gain mesuré par le projet tombe à 3 % pour /caveman (35 % pour /ultracave). Et si vous payez à la requête, comme sur GitHub Copilot, une réponse plus courte n’économise rien.
Pour mesurer chez soi, la CLI propose caveman trial -- claude, qui lance un A/B sur une vraie session, et caveman learn, qui analyse l’historique déjà sur disque :
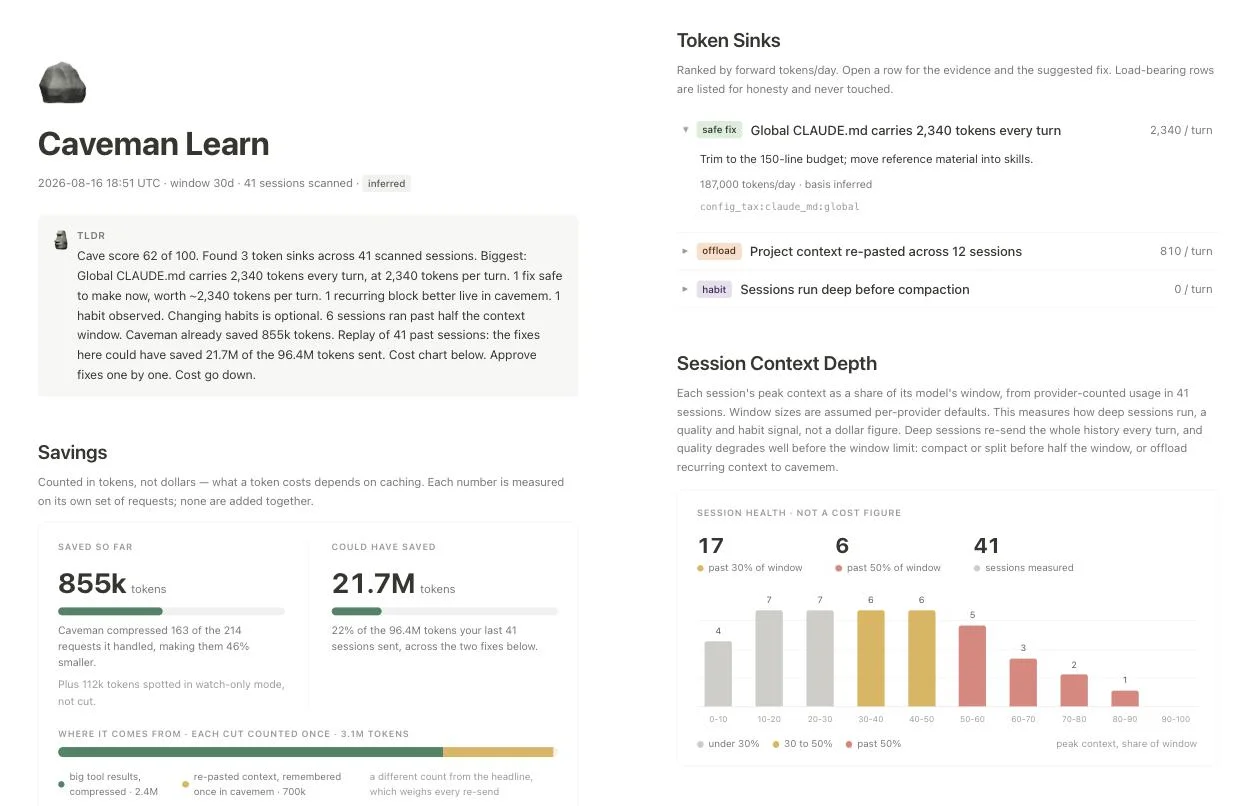
Capture du rapport caveman learn publiée dans le README. Le premier poste détecté est un CLAUDE.md global trop lourd, renvoyé à chaque tour.
C’est à mon avis la partie la plus utile, et elle rejoint ce que j’écrivais sur le harness engineering : un fichier d’instructions trop gras coûte plus cher, tour après tour, que n’importe quelle phrase de politesse de l’agent.
⚠️ Quelques précautions
-
Lisibilité. Une réponse de 20 mots se lit vite quand on connaît le sujet. Sur un bug que je ne comprends pas encore, je veux le raisonnement. Cavaglione arrive à la même conclusion : intéressant à grande échelle, moins pour un dev seul qui suit son agent.
-
Le proxy modifie votre config. Pour Claude Code, il écrit
ANTHROPIC_BASE_URLdans~/.claude/settings.json, ce qui rend Remote Control indisponible tant que Caveman route. Si vous pointez déjà vers un autre endpoint, Caveman n’y touche pas. -
Télémétrie activée par défaut sur la CLI (commandes, compteurs de tokens, IP, jamais le code selon
SECURITY.md).caveman telemetry offouDO_NOT_TRACK=1pour la couper. -
Désactivez le routeur. C’est ma recommandation, surtout sur un projet client. Dès qu’on se connecte et qu’on choisit Auto dans le sélecteur de modèle, chaque demande part vers Caveman Cloud avec ce que l’agent y joint (CLAUDE.md, mémoire, fichiers mentionnés), la demande précédente et la fin de la dernière réponse. Sur le plan gratuit, Caveman peut les conserver pour améliorer son routage. Une requête routée vers un modèle hébergé par Caveman Cloud y passe en entier : prompt système, résultats d’outils, code. Bref, votre code part chez un tiers de plus. Deux commandes coupent ces flux :
caveman off routing         # plus de module de routage (Auto)
caveman providers cloud off # aucune requête vers les modèles Caveman Cloud
Le proxy local, lui, continue d’envoyer vos requêtes au seul fournisseur choisi par l’agent, avec votre clé.
-
La licence a changé. MIT pour le skill et BSL pour le runtime avant la 3.0, Apache-2.0 pour tout le dépôt depuis.
🎉 Conclusion
Caveman a commencé comme une blague sur la verbosité des LLM, et le skill reste une bonne idée modeste : les tests indépendants trouvent 8 à 14 % de tokens de sortie en moins sur du travail d’agent, sans perte de qualité mesurée, mais un impact quasi nul sur la facture totale. Si vous avez déjà « sois concis » dans votre CLAUDE.md, l’écart fond encore.
Le levier sérieux est côté entrée : compresser les logs et les sorties d’outils, alléger le contexte renvoyé à chaque tour. Là, le proxy et caveman learn ont des arguments, avec le prix d’un composant de plus entre vous et votre fournisseur. Je commencerais par caveman learn en lecture seule, pour savoir où partent mes tokens, et je laisserais le routeur coupé (caveman off routing) pour que le code reste entre ma machine et mon fournisseur. Et si vous faites tourner plusieurs agents en parallèle, c’est là que quelques pourcents par session finissent par compter.
🔗 Liens utiles
- Dépôt GitHub JuliusBrussee/caveman
- Notes de version 4.1.0
- Honest Numbers : les chiffres où Caveman perd
- Le SKILL.md de Caveman
- JetBrains : Does Speaking to Agents Like Cavemen Really Save 65% of Tokens?
- Nathan Cavaglione : I Tested The Viral Caveman Prompt On 100 Coding Tasks
- Caveman sur Y Combinator
/faq
Questions fréquentes
Qu'est-ce que Caveman ?
+
Caveman est un projet open source (Apache-2.0 depuis la 3.0) de Julius Brussee, lancé en avril 2026. Il combine un skill qui fait répondre l'agent de code en phrases très courtes, en gardant code, commandes et erreurs à l'identique, et un proxy local qui compresse ce que l'agent lit (logs, JSON, sorties de tests).
Caveman réduit-il vraiment les tokens de 65 % ?
+
Pas sur une session d'agent complète. Le chiffre de 65 % venait de réponses de type chat. JetBrains mesure 8,5 % de tokens de sortie en moins sur 86 tâches agentiques, et un autre test sur SWE-bench Pro trouve 14 % de sortie et 12 % de coût en moins. Le README actuel ne revendique plus ce 65 %.
Quelle différence entre le skill Caveman et le proxy ?
+
Le skill ne touche qu'à la sortie du modèle : c'est une consigne de style. Le proxy, installé par la CLI, s'intercale entre l'agent et le fournisseur et compresse l'entrée (résultats d'outils, fichiers), en gardant l'original sur disque pour que l'agent puisse le récupérer.
Caveman dégrade-t-il la qualité du code produit ?
+
Les mesures publiées ne montrent pas de dégradation significative : JetBrains trouve des scores statistiquement indiscernables (p = 0,82) sur 82 paires de tâches. Le skill laisse les blocs de code intacts et repasse en phrases complètes pour les alertes de sécurité et les actions irréversibles.