🧰 Harness engineering : histoire, mise en place et exploitation du harnais de vos agents
📚 Introduction
Quand un agent de code se plante, le premier réflexe est d’accuser le modèle. Pas assez malin, il hallucine, la prochaine version fera mieux. Parfois c’est vrai. Mais le plus souvent, en relisant la session, on tombe sur autre chose : l’agent ne savait pas quelle commande lance les tests, il a inventé une convention faute de trouver la vraie, ou il a annoncé « c’est fini » sans que rien ne l’oblige à vérifier.
Ces trois échecs ont la même cause, et elle n’est pas dans les poids du modèle. Elle est dans ce qui l’entoure : le harness (harnais), et depuis février 2026 la façon de le construire a un nom, le harness engineering. Le terme s’est imposé en quelques semaines.
Je prends ici volontairement plus de place que d’habitude : l’histoire du mot (elle explique pourquoi il arrive maintenant), la mise en place concrète, indépendante de votre stack, puis l’exploitation au quotidien, qui est la partie que tout le monde sous-estime.
🔎 Qu’est-ce que le harness engineering ?
C’est l’art de concevoir tout ce qui, dans un agent, n’est pas le modèle. Birgitta Böckeler (Thoughtworks) reprend sur martinfowler.com une formule qui a fait le tour : Agent = Model + Harness. Le harnais regroupe le prompt système, les fichiers d’instructions, les outils, la boucle d’agent, la gestion du contexte, les hooks, les permissions, et, autour, l’environnement du projet : tests, linters, CI, observabilité.
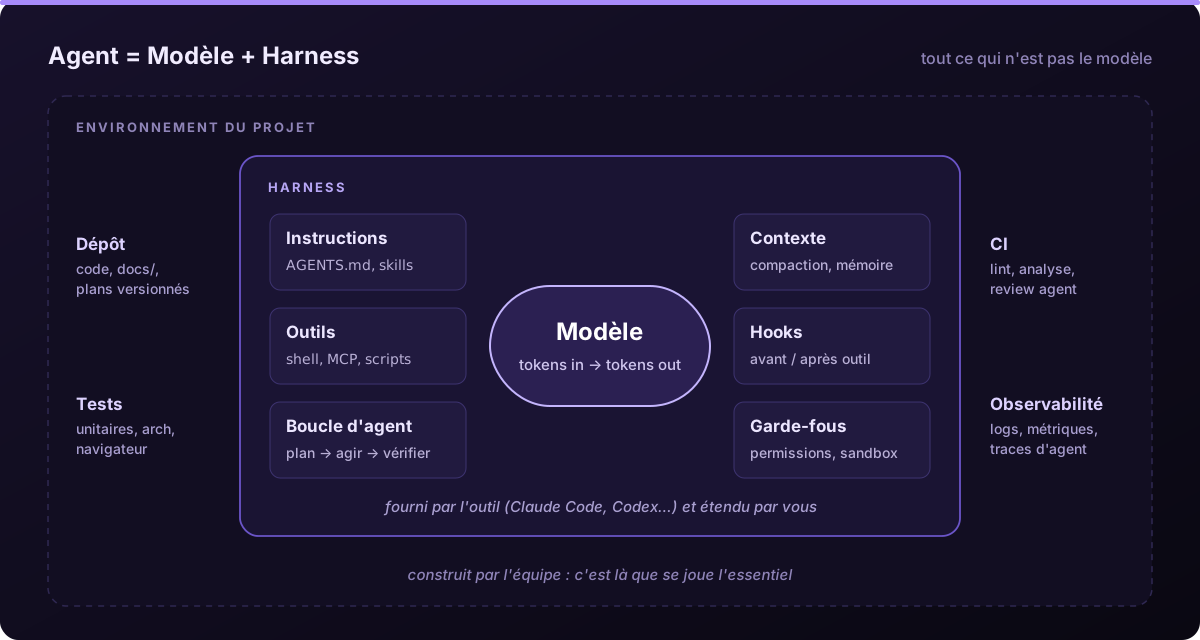
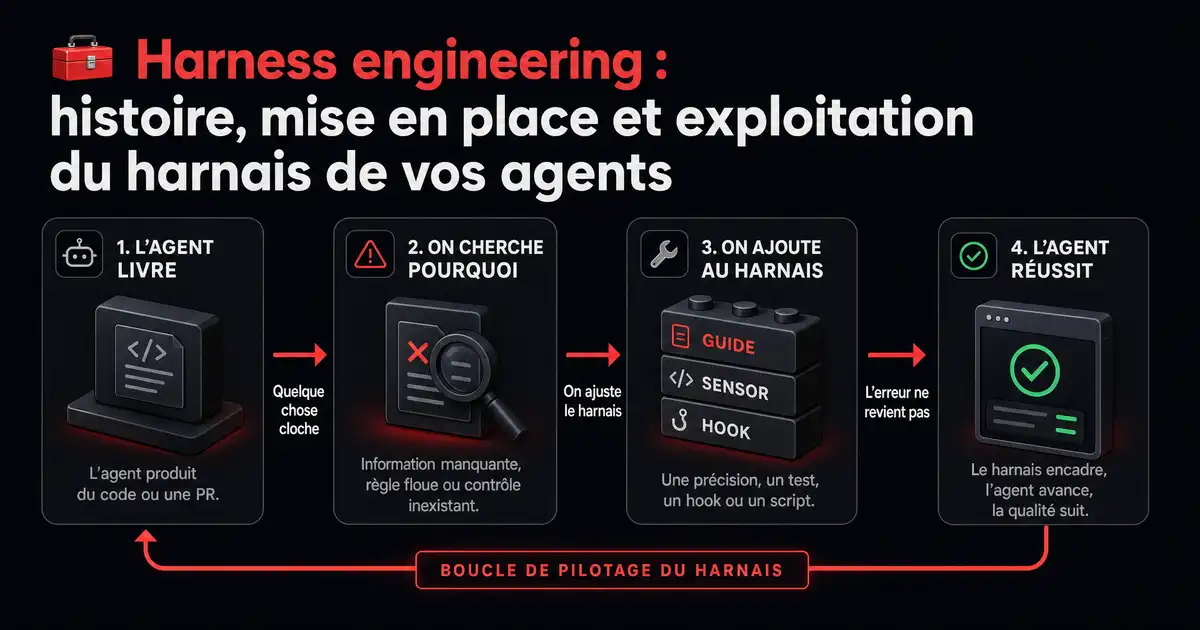
Une partie de ce harnais vous est livrée par l’outil. Claude Code, Codex ou Cursor viennent avec leur boucle, leurs outils de lecture et d’écriture, leur compaction de contexte. L’autre partie, c’est vous qui l’écrivez, et c’est celle qui fait la différence sur votre projet. Mitchell Hashimoto en donne la définition la plus opérationnelle : chaque fois qu’un agent fait une erreur, on prend le temps de construire une solution pour qu’il ne la refasse plus jamais.
Retenez cette définition, tout le reste en découle.
🕰️ D’où vient le mot ?
Le terme n’est pas sorti de nulle part, et son parcours explique pourquoi il s’impose en 2026 plutôt qu’en 2023.
Le harnais de test, bien avant l’IA
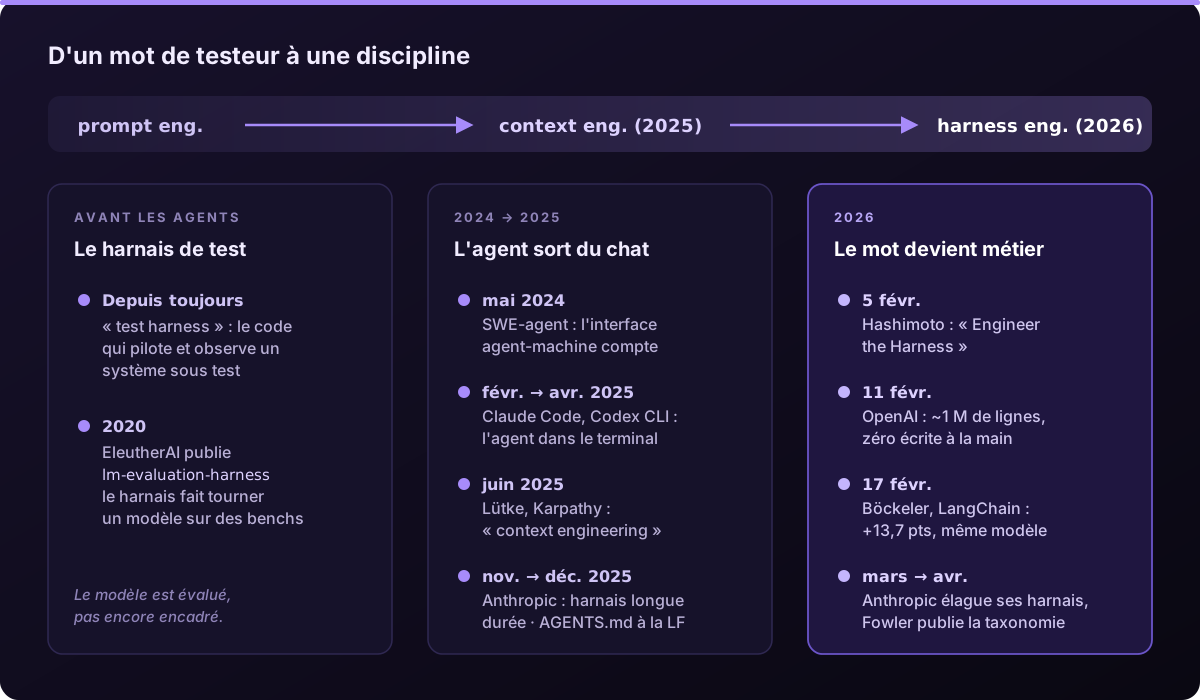
En test logiciel, un test harness désigne depuis longtemps l’outillage qui pilote un système sous test, lui injecte des entrées et observe ce qui en sort : stubs, drivers, scripts d’exécution. Le monde du machine learning a repris le mot tel quel. En 2020, EleutherAI publie lm-evaluation-harness, le cadre qui fait passer un modèle de langage sur des dizaines de benchmarks. À ce stade, le harnais sert à mesurer un modèle. Personne ne parle encore de l’encadrer.
2024-2025 : l’agent sort du chat
Tout bascule quand le modèle cesse de répondre dans une fenêtre de chat pour agir dans un vrai environnement. En mai 2024, l’équipe de Princeton derrière SWE-agent montre qu’à modèle égal, la qualité de l’« interface agent-ordinateur » (les commandes qu’on lui expose, le format des retours) change nettement le taux de résolution des tickets. C’est la première démonstration chiffrée qu’autour du modèle, il y a de l’ingénierie à faire.
En 2025, les agents débarquent dans le terminal des développeurs : Claude Code en février, Codex CLI en avril. Chacun arrive avec son fichier d’instructions (CLAUDE.md, AGENTS.md), et le vocabulaire suit. En juin, Tobi Lütke (Shopify) puis Andrej Karpathy défendent le terme context engineering contre « prompt engineering » : l’enjeu n’est plus de bien tourner une phrase, mais de remplir la fenêtre de contexte avec la bonne information à chaque étape.
Fin 2025, deux signaux de plus. Le 26 novembre, Anthropic publie « Effective harnesses for long-running agents » : un agent initialiseur écrit une liste de fonctionnalités en JSON (toutes marquées en échec), un script init.sh et un fichier de progression, puis des agents de code successifs avancent une fonctionnalité à la fois, testent dans un navigateur et laissent le dépôt propre pour la session suivante. Le 9 décembre, la Linux Foundation crée l’Agentic AI Foundation, avec MCP (donné par Anthropic) et AGENTS.md (donné par OpenAI) parmi les projets fondateurs. Le fichier d’instructions pour agents devient un standard neutre.
Février 2026 : le mot devient une discipline
Le 5 février, Mitchell Hashimoto (Terraform, Ghostty) publie « My AI Adoption Journey ». L’étape 5 s’intitule « Engineer the Harness » : à chaque erreur d’agent, soit on complète l’AGENTS.md (mauvaises commandes, mauvaises API), soit on écrit un outil (un script de capture d’écran, un lanceur de tests filtrés) qu’on signale dans l’AGENTS.md.
Six jours plus tard, le 11 février, OpenAI publie « Harness engineering: leveraging Codex in an agent-first world », signé Ryan Lopopolo. Le récit frappe les esprits : environ cinq mois de développement d’un produit interne, quelque chose comme un million de lignes de code et 1 500 pull requests, sans une ligne écrite à la main. L’équipe démarre à trois ingénieurs et finit à sept, et la phrase qui résume le tout tient en quatre mots : « Humans steer. Agents execute. »
Le 17 février, Böckeler publie ses premières réflexions sur martinfowler.com et classe le harnais d’OpenAI en trois familles : ingénierie du contexte, contraintes d’architecture, « garbage collection ». Le même jour, LangChain montre que son agent deepagents-cli passe de 52,8 % à 66,5 % sur Terminal Bench 2.0 en ne touchant qu’au harnais : prompt système, outils, middlewares. Même modèle (gpt-5.2-codex), treize points de plus.
Au printemps, deux textes donnent de la profondeur au sujet. Le 24 mars, Anthropic décrit un harnais à trois agents (planificateur, générateur, évaluateur) et raconte surtout comment il l’a allégé à chaque nouveau modèle. Le 2 avril, Böckeler publie « Harness engineering for coding agent users », qui pose la taxonomie qu’on va utiliser dans la suite.
🧩 Guides et sensors : la grille de lecture
Le texte de Böckeler a le mérite de ranger proprement ce qu’on met dans un harnais, selon deux axes.
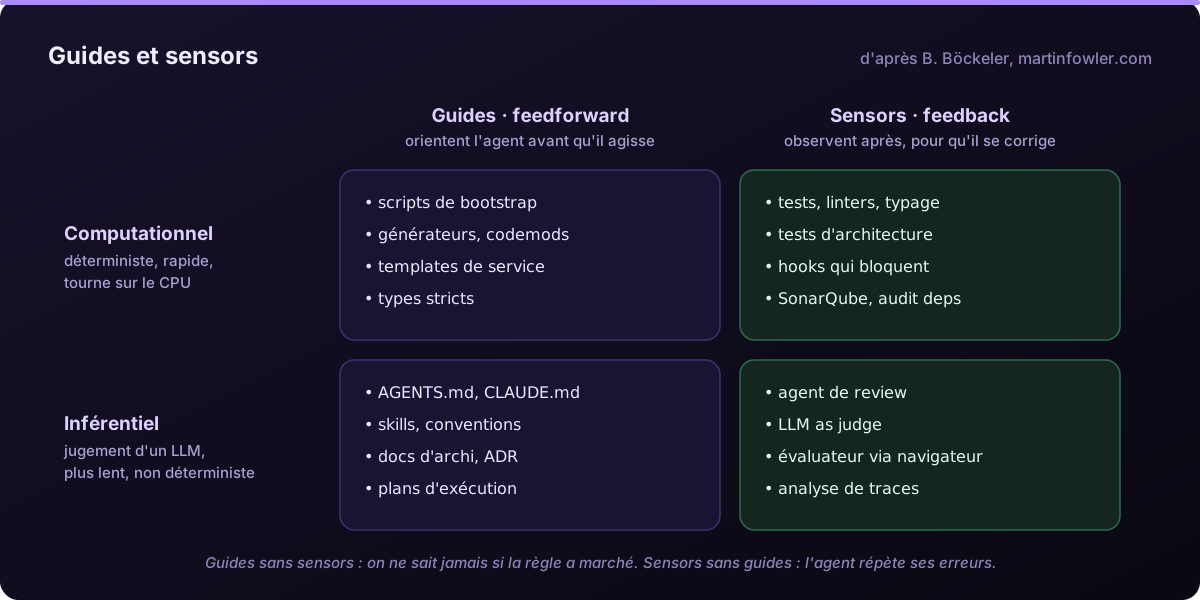
Le premier axe sépare les guides (feedforward), qui orientent l’agent avant qu’il agisse, des sensors (feedback), qui observent ce qu’il a produit pour qu’il se corrige. Un AGENTS.md est un guide. Un test qui casse est un sensor. Les deux sont nécessaires : avec seulement des sensors, l’agent répète les mêmes erreurs à chaque session ; avec seulement des guides, on ne sait jamais si la règle a été suivie.
Le second axe oppose le computationnel, déterministe, rapide, qui tourne sur un CPU (tests, linters, typage, analyse structurelle), à l’inférentiel, qui repose sur le jugement d’un LLM (review par agent, « LLM as judge », vérification sémantique). Le computationnel est fiable et peu coûteux, l’inférentiel couvre ce qu’aucune règle ne sait exprimer. La règle pratique qui en découle : tout ce qui peut être vérifié de façon déterministe doit l’être, et on garde le jugement d’un modèle pour le reste.
Böckeler découpe aussi le harnais par ce qu’il régule. Le harnais de maintenabilité (qualité interne du code) est le plus facile à construire. Le harnais d’architecture vérifie les caractéristiques structurelles, à la manière des fitness functions. Le harnais de comportement doit garantir que l’application fait ce qu’on attend d’elle, et c’est, selon elle, « l’éléphant dans la pièce » : le problème n’est pas résolu.
🚀 Mise en place, étape par étape
Assez de théorie. Voici l’ordre dans lequel je monte un harnais sur un projet, du plus rentable au plus ambitieux. Rien ici ne dépend du langage : les exemples sont en pseudo-code, à traduire dans vos outils (Makefile, scripts npm, justfile, shell…). Quand je parle de hooks, je prends Claude Code comme référence, mais chaque étape a son équivalent chez les autres agents.
Étape 0 : un projet qui se lance en une commande
C’est la marche que tout le monde saute, et c’est celle qui coûte le plus cher. Si un humain a besoin de trois messages Slack pour lancer les tests, l’agent va deviner, et mal. Anthropic en fait la première responsabilité de son agent initialiseur : écrire un init.sh que chaque session exécute avant toute chose.
Peu importe l’outil, ce qui compte est d’avoir deux points d’entrée stables :
commande setup :
    installer les dépendances
    préparer la configuration locale
    créer et migrer la base de données

commande check :          // tout ce qui doit être vert avant de dire « fini »
    formater
    linter
    vérifier les types
    lancer les tests
setup pour démarrer, check pour savoir si tout est vert. L’agent ne peut pas les rater, et les humains de l’équipe non plus.
Étape 1 : un AGENTS.md qui sert de carte
L’erreur classique consiste à écrire une encyclopédie. L’équipe OpenAI raconte avoir essayé le gros fichier unique et avoir échoué : le contexte est limité, et l’agent passait à côté des contraintes qui comptaient. Leur AGENTS.md est devenu une carte qui pointe vers un dossier docs/ structuré (documents de design, plans d’exécution versionnés, specs produit, références), considéré comme la source de vérité. Ce qui vit dans Slack ou dans la tête des gens n’existe pas pour l’agent.
La doc de Claude Code va dans le même sens : viser moins de 200 lignes par CLAUDE.md, parce qu’un fichier plus long consomme du contexte et réduit l’adhérence aux consignes. Un point pratique au passage : Claude Code lit un AGENTS.md quand il n’y a pas de CLAUDE.md, ou via un import @AGENTS.md depuis le CLAUDE.md. Un seul fichier peut donc servir à tous vos agents.
# AGENTS.md

<Ce que fait le projet, en une phrase.> <Comment le dépôt est découpé.>

## Commandes

- Installer et préparer : <commande setup>
- Tout vérifier (à lancer avant de dire « fini ») : <commande check>
- Lancer un seul test : <commande pour un test ciblé>

## Où trouver quoi

- Architecture et règles de dépendance : <lien vers la doc d'architecture>
- Conventions de code et de nommage : <lien vers les conventions>
- Plan en cours et décisions : <dossier des plans>
- Vocabulaire métier : <lien vers le glossaire>

## Règles non négociables

- <La règle d'architecture qui coûte le plus cher si on l'enfreint.>
- <La règle de test minimale pour toute nouvelle fonctionnalité.>
- <L'opération irréversible à ne jamais faire.>

## Quand tu es bloqué

Écris ce qui bloque dans <le plan du ticket> plutôt que de contourner.
C’est un squelette : chaque <…> est à remplacer par ce qui vaut pour votre projet. Le fichier ne contient presque aucune règle en propre. Il dit où chercher, comment vérifier, et les trois choses qui coûtent cher si on se trompe. Les conventions génériques du langage ou du framework, le modèle les connaît déjà ; le fichier ne porte que ce qui est propre au projet. Sur un monorepo, un AGENTS.md par sous-projet fonctionne bien : l’agent lit le plus proche du fichier qu’il modifie.
Étape 2 : des sensors déterministes
Une règle écrite dans un AGENTS.md reste une suggestion. Le modèle la suivra souvent, pas toujours. La doc de Claude Code le dit sans détour : les fichiers d’instructions sont du contexte, pas de la configuration imposée. Une règle qui compte doit donc aussi exister sous forme de contrôle qui casse.
La bonne nouvelle, c’est que l’outillage existe dans tous les écosystèmes : formateur, linter, typage strict ou analyse statique, et surtout tests d’architecture. ArchUnit en Java, dependency-cruiser en JavaScript/TypeScript, import-linter en Python, Deptrac en PHP : tous permettent d’écrire « telle couche n’importe jamais telle autre » et de faire échouer le build sinon. C’est exactement ce que décrit OpenAI : des dépendances qui ne vont que dans un sens, vérifiées par des linters maison et des tests structurels, pas par la bonne volonté du modèle.
Quand aucun outil ne couvre une règle, un script de quelques lignes suffit souvent :
contrôle « la couche A ne dépend pas de la couche C » :
    pour chaque fichier de <couche A> :
        si le fichier importe <couche C> :
            afficher "ERREUR : <couche A> importe <couche C> directement."
            afficher "CORRECTION : passe par <couche B> (voir <doc d'architecture>)."
            échouer
Regardez la deuxième ligne d’erreur, c’est elle qui compte : le message est écrit pour l’agent. OpenAI rédige les messages de ses linters pour qu’ils contiennent l’instruction de correction, puisque c’est exactement ce que l’agent va lire. « Import interdit » est correct ; « passe par
Étape 3 : brancher les sensors dans la boucle avec des hooks
Avoir des contrôles ne suffit pas si l’agent ne les lance pas. Les hooks règlent ça : des commandes exécutées à des moments précis du cycle de l’agent (avant ou après un outil, au moment de s’arrêter), de façon déterministe. Un hook peut bloquer l’action en cours et renvoyer un message à l’agent, qui le lit comme une consigne. Dans Claude Code, c’est un code de sortie 2, et le contenu de stderr devient l’explication. Deux hooks me servent sur tous les projets.
Le premier se déclenche après chaque édition de fichier et lance les contrôles rapides sur ce seul fichier :
après chaque modification de fichier par l'agent :
    se placer à la racine du projet
    lancer les contrôles rapides sur ce seul fichier
    si un contrôle échoue :
        bloquer, en renvoyant à l'agent :
            "Problèmes détectés dans <fichier> : <sortie des outils>"
            "Corrige-les avant de continuer (règles : docs/conventions.md)."
Le second empêche l’agent de s’arrêter tant que la vérification complète ne passe pas. C’est la réponse au mode d’échec que tout le monde a vu, et que LangChain a traité avec son PreCompletionChecklistMiddleware : l’agent relit son code, le trouve beau, et déclare victoire sans rien lancer.
quand l'agent veut s'arrêter :
    se placer à la racine du projet
    lancer la commande check

    si tout est vert :
        remettre le compteur de tentatives à zéro
        laisser l'agent s'arrêter

    incrémenter le compteur de tentatives
    si compteur > 3 :                       // garde-fou contre la boucle infinie
        remettre le compteur à zéro
        laisser l'agent s'arrêter           // un humain prend le relais, la CI tranche

    bloquer, en renvoyant à l'agent :
        "La vérification échoue (tentative N/3), tu ne peux pas t'arrêter :"
        les 40 dernières lignes de la sortie
Quelques détails évitent les mauvaises surprises. Un hook s’exécute dans le répertoire courant de la session, qui peut être un sous-dossier du monorepo : d’où le « se placer à la racine » en tête des deux hooks. Un script copié depuis un article n’est pas forcément exécutable : vérifiez ses droits avant de le brancher. Et les deux hooks se déclarent dans la configuration du projet (.claude/settings.json pour Claude Code), versionnée avec le code pour que toute l’équipe en profite.
Le compteur n’est pas décoratif. Sans lui, l’agent tourne en rond sur un problème qu’il ne sait pas résoudre ; avec une simple relance unique, il pourrait s’arrêter tests toujours rouges. Le hook revérifie donc à chaque tentative et ne rend la main qu’après trois échecs consécutifs. À ce stade, c’est à un humain de regarder, et c’est la CI qui reste le contrôle obligatoire avant tout merge : le hook raccourcit la boucle, il ne remplace pas le pipeline. Sur une grosse suite de tests, ciblez plutôt les tests liés aux fichiers modifiés, sinon chaque fin de tâche prendra des minutes.
Étape 4 : des sensors inférentiels
Certaines règles ne se codent pas. « Ce nom de méthode reflète-t-il le métier ? », « cette PR mélange-t-elle deux sujets ? », « ce message d’erreur est-il compréhensible pour un client ? ». C’est le terrain des sensors inférentiels : un agent de review lancé en CI avec ses propres instructions, une skill de relecture, un évaluateur qui joue le rôle du client.
Je les place après les sensors déterministes, jamais à leur place. Ils sont plus lents, plus chers, et leur verdict varie d’une exécution à l’autre. Un agent de review qui signale une faute de style que le formateur aurait corrigée, c’est du budget gâché.
Étape 5 : le harnais de comportement
C’est la case vide de la grille, celle que Böckeler juge non résolue. Elle relève d’ailleurs dans le retour d’OpenAI l’absence de vérification fonctionnelle : leur harnais protège surtout la maintenabilité. Les tests unitaires écrits par l’agent ne suffisent pas, puisqu’ils peuvent valider exactement la même compréhension erronée que le code.
Ce qui marche le mieux aujourd’hui : faire tester l’application comme un utilisateur. Anthropic l’a constaté sur ses agents longue durée, où les tests unitaires et les appels curl laissaient passer des fonctionnalités cassées de bout en bout, jusqu’à ce que l’agent pilote un vrai navigateur. Playwright, directement ou via un serveur MCP, est aujourd’hui le choix le plus répandu pour ça. Et la règle d’or : les tests d’acceptation sont écrits ou validés par un humain, l’agent n’a le droit que de les faire passer. Anthropic applique le même principe à son fichier de fonctionnalités, où l’agent ne peut modifier qu’un champ passes.
⏱️ Où placer chaque contrôle ?
Le plus tôt possible. Böckeler résume ça en « keep quality left » : une erreur attrapée pendant la session est corrigée par l’agent seul, en quelques secondes ; la même erreur découverte en production vous coûte une revue, un revert, peut-être un postmortem.
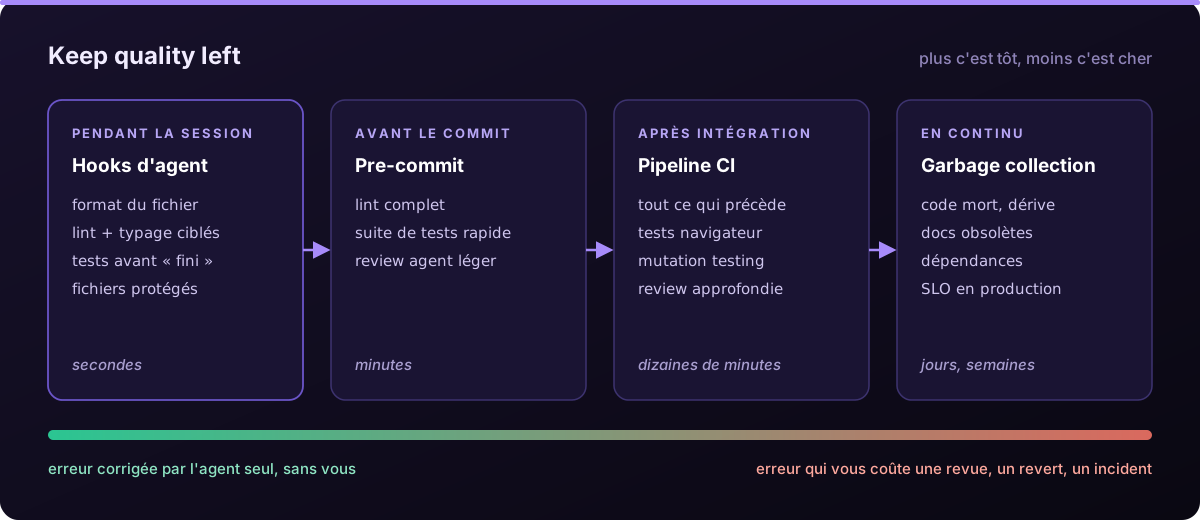
Concrètement, j’organise les contrôles en quatre étages :
- Pendant la session : les hooks de l’étape 3. Rapides et ciblés sur le fichier touché.
- Avant le commit : lint complet, tests rapides, éventuellement une review légère.
- Dans la CI : tout ce qui précède rejoué, plus ce qui est trop lent pour la boucle locale (tests navigateur, mutation testing, analyse SonarQube, review approfondie). Le pipeline GitLab CI ou GitHub Actions que vous avez déjà est un harnais, il suffit de le voir comme tel.
- En continu : des contrôles qui ne dépendent d’aucun changement (code mort, docs qui ne correspondent plus au code, dépendances vulnérables, SLO en production).
🔁 Exploitation : faire vivre le harnais
Un harnais n’est jamais terminé. C’est la partie qu’on oublie dans les démos, et c’est celle qui sépare une équipe qui « essaie les agents » d’une équipe qui en tire vraiment quelque chose.
La boucle de pilotage
Böckeler décrit le rôle de l’humain comme celui de quelqu’un qui pilote l’agent en itérant sur le harnais. Hashimoto le dit autrement, mais c’est la même mécanique.
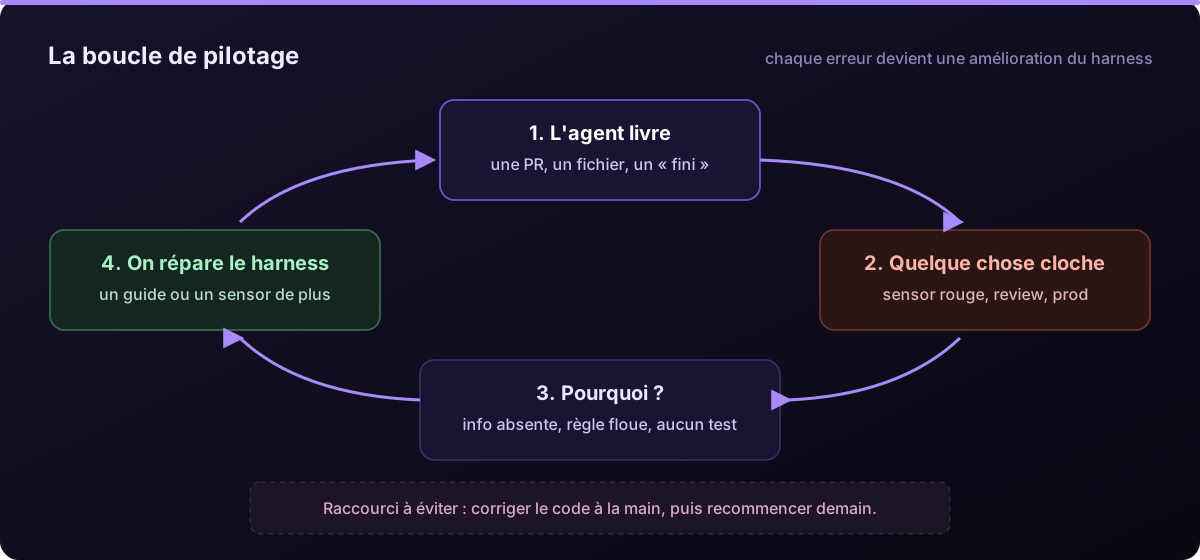
Quand l’agent se trompe, la tentation est de corriger le code soi-même et de passer à autre chose. Ça règle le ticket. Ça ne règle rien pour demain. La bonne question est celle qu’on pose en postmortem blameless : qu’est-ce qui, dans le système, a rendu cette erreur possible ? En pratique, la réponse tombe presque toujours dans l’une de ces trois cases :
- L’information manquait : l’agent ne pouvait pas savoir. On ajoute une ligne dans l’
AGENTS.mdou une page dansdocs/. - La règle était floue ou contradictoire : on la réécrit, et si elle compte, on la transforme en contrôle déterministe.
- Rien ne permettait de vérifier : on ajoute un test, un hook, un script que l’agent peut lancer.
La doc de Claude Code donne le même déclencheur, formulé simplement : on ajoute une consigne quand l’agent fait la même erreur une deuxième fois, ou quand une review attrape quelque chose qu’il aurait dû savoir.
Lire les traces plutôt que deviner
Pour savoir ce qui ne va pas, il faut regarder ce que l’agent a réellement fait. LangChain a monté toute son amélioration sur Terminal Bench sur l’analyse des traces de ses agents : une skill dédiée y repère les motifs d’échec récurrents et propose des changements de harnais. Ils en tirent un avertissement que je trouve juste : un correctif taillé pour une tâche précise peut faire régresser les autres. Un harnais se teste comme du code.
Leurs autres trouvailles sont réutilisables telles quelles : un middleware qui détecte qu’un agent modifie le même fichier en boucle et l’invite à reconsidérer son approche, un autre qui cartographie le répertoire de travail dès le départ pour lui éviter de chercher, et des rappels de temps pour qu’il réserve la fin de session à la vérification plutôt que de la découvrir trop tard.
Sans aller jusque-là, relire régulièrement deux ou trois sessions qui ont mal tourné apprend plus sur votre harnais que n’importe quel tableau de bord.
La garbage collection
Un agent produit vite, et la dette s’accumule au même rythme. L’équipe OpenAI a fini par traiter ça comme un ramasse-miettes : des agents tournent en tâche de fond, cherchent les écarts entre le code et la documentation ou les violations d’architecture, et ouvrent des PR de nettoyage. Le nettoyage n’est plus un sprint qu’on repousse indéfiniment, il devient un flux continu de petites corrections.
Sur un projet plus modeste, un job planifié en CI qui lance l’agent en mode non interactif (claude -p pour Claude Code) avec une consigne précise (« compare docs/architecture.md au code et propose une PR si ça diverge ») fait déjà une bonne partie du travail. Gardez ces PR petites et relues : un agent de nettoyage sans garde-fous produit lui aussi de l’entropie.
Élaguer quand le modèle progresse
C’est le point le plus contre-intuitif, et le texte d’Anthropic de mars 2026 l’explique très bien : chaque composant d’un harnais encode une hypothèse sur ce que le modèle ne sait pas faire seul. Quand le modèle progresse, l’hypothèse peut devenir fausse, et le composant n’est plus qu’un coût.
Leur propre harnais en témoigne. Avec Opus 4.5, les réinitialisations de contexte entre sessions sont devenues inutiles et ont été remplacées par une session continue avec compaction automatique. Avec Opus 4.6, le découpage en sprints a disparu ; l’agent planificateur est resté, parce que sans lui le générateur sous-dimensionnait le travail ; l’évaluateur est passé d’une vérification par sprint à une seule passe finale.
J’en tire une habitude : à chaque changement de modèle, je relis mes instructions et mes hooks en me demandant lesquels compensent une faiblesse qui n’existe plus. Un AGENTS.md qui rappelle en majuscules des choses que le modèle fait désormais très bien, c’est du contexte payé pour rien. Claude Code propose d’ailleurs un audit de ses fichiers d’instructions (/doctor prompt-audit) qui repère entre autres les consignes écrites pour d’anciens modèles.
Mesurer
Vous ne saurez pas si le harnais s’améliore sans le mesurer. Pas besoin d’inventer de nouvelles métriques : les métriques DORA s’appliquent telles quelles au code produit par un agent. Le taux d’échec des changements dit si vos sensors attrapent ce qu’il faut ; le délai de livraison dit si le harnais fluidifie ou ralentit. J’y ajoute deux compteurs simples : la part de PR d’agent mergées sans retouche humaine, et le nombre d’erreurs récurrentes (celles qui reviennent alors qu’on croyait les avoir traitées).
🧱 Tous les projets ne se harnachent pas aussi bien
Böckeler parle de harnessability : certaines bases de code se prêtent mieux que d’autres à l’encadrement. Un typage fort, des frontières de modules nettes, un framework aux conventions marquées donnent prise aux contrôles. Un projet avec un typage strict, une analyse statique au niveau maximal et un framework aux conventions fortes a déjà la moitié de son harnais construit, souvent sans le savoir.
À l’inverse, un vieux projet sans tests, aux couches poreuses, est difficile à encadrer. Böckeler doute même que le rattrapage vaille toujours l’effort sur les bases chargées d’entropie. Mon avis est plus nuancé : on peut harnacher par îlots. Un module refondu avec ses tests d’architecture et son AGENTS.md local (l’agent lit le fichier le plus proche de ce qu’il modifie) devient une zone où l’agent travaille bien, pendant que le reste attend.
Elle soulève aussi deux conséquences à plus long terme. Les harnais pourraient devenir les nouveaux templates de service, les « golden paths » des équipes plateforme, avec le même risque de forks qui divergent. Et les équipes pourraient choisir leur stack en fonction de la qualité des harnais disponibles plutôt que de leurs goûts. Les frameworks qui livrent leurs propres guidelines et serveurs MCP pour agents en sont les prémices.
⚠️ Quelques précautions
Le harnais n’est pas gratuit. L’équipe OpenAI y a consacré cinq mois, avec beaucoup d’outillage déterministe sur mesure. Böckeler insiste là-dessus : on est très loin d’un fichier de règles en Markdown. Commencez petit, et n’ajoutez une pièce que quand une erreur réelle la justifie.
Les chiffres spectaculaires ne se transposent pas. Un million de lignes sans code humain, c’est un produit neuf, conçu dès le départ pour des agents, par une équipe qui fabrique les modèles. Sur votre projet legacy, l’objectif raisonnable est plus modeste : moins de corrections répétées, des PR d’agent qu’on relit plus vite.
Un hook bloquant mal écrit paralyse l’agent. Une analyse statique qui met 90 secondes après chaque édition, ou un hook Stop sans garde contre la boucle, et la session devient inutilisable. Ciblez les fichiers modifiés, et testez vos hooks comme n’importe quel script.
L’agent peut tricher avec ses sensors. Un agent sous pression de faire passer les tests peut affaiblir une assertion ou ajouter un commentaire qui désactive le linter. Protégez les fichiers sensibles (un hook PreToolUse qui bloque l’édition de tests/acceptance/ ou de la config du linter), et surveillez ces motifs en review.
Les instructions vieillissent. Une doc obsolète est pire que pas de doc : l’agent la croit. Mettez les fichiers d’instructions dans le périmètre de la garbage collection, et relisez-les à chaque changement de modèle.
Le jugement humain reste au centre. Un bon harnais ne cherche pas à se passer des humains, il dirige leur attention là où elle compte : les specs, l’architecture, les tests d’acceptation, les arbitrages produit. Si votre harnais vous donne l’impression de ne plus rien comprendre à votre propre code, il est mal réglé.
🎉 Conclusion
Le harness engineering n’invente presque rien. Des tests, des linters, de la doc à jour, une CI qui casse quand il faut, une culture où l’on corrige le système plutôt que de blâmer l’individu : c’est le b.a.-ba du génie logiciel. Ce qui change, c’est le destinataire. Ces pratiques servaient d’abord à des humains qui pouvaient compenser leurs manques en demandant à un collègue. L’agent, lui, ne demande rien : il fait avec ce qu’on lui donne.
Si vous ne deviez faire que trois choses cette semaine : une commande unique qui installe et vérifie le projet, un AGENTS.md court qui pointe vers le reste, et un hook qui refuse le « c’est fini » tant que la vérification est rouge, avec la CI comme juge final. Ensuite, à chaque erreur de l’agent, posez-vous la question de Hashimoto : qu’est-ce que je construis pour qu’elle ne revienne pas ?
🔗 Liens utiles
- Mitchell Hashimoto, « My AI Adoption Journey » (5 février 2026)
- OpenAI, « Harness engineering: leveraging Codex in an agent-first world » (11 février 2026)
- Birgitta Böckeler, « Harness Engineering, first thoughts » (martinfowler.com)
- Birgitta Böckeler, « Harness engineering for coding agent users » (martinfowler.com)
- Anthropic, « Effective harnesses for long-running agents »
- Anthropic, « Harness design for long-running application development »
- LangChain, « Improving Deep Agents with harness engineering »
- AGENTS.md, le format ouvert d’instructions pour agents
- Claude Code : hooks
- Claude Code : CLAUDE.md, AGENTS.md et mémoire
- ArchUnit, tests d’architecture
/faq
Questions fréquentes
Qu'est-ce que le harness engineering ?
+
C'est la discipline qui consiste à concevoir et faire évoluer tout ce qui entoure le modèle d'un agent de code : instructions (AGENTS.md, skills), outils, hooks, tests, linters, CI et observabilité. La formule reprise par Birgitta Böckeler sur martinfowler.com le résume : Agent = Modèle + Harness.
Qui a inventé le terme harness engineering ?
+
Le mot harness existait déjà (test harness, lm-evaluation-harness). Mitchell Hashimoto a nommé la pratique le 5 février 2026 dans « My AI Adoption Journey », OpenAI l'a popularisée le 11 février avec son retour d'expérience Codex, et Birgitta Böckeler l'a formalisée sur martinfowler.com en février puis en avril 2026.
Quelle différence entre context engineering et harness engineering ?
+
Le context engineering s'occupe de ce qu'on met dans la fenêtre de contexte du modèle à chaque étape. Le harness engineering l'englobe et va plus loin : il ajoute les contrôles déterministes (tests, linters, hooks qui bloquent), la boucle de vérification et l'amélioration continue du dispositif à chaque erreur de l'agent.
Par où commencer un harnais sur un projet existant ?
+
Par une commande unique qui installe et teste le projet, un AGENTS.md court qui sert de carte, puis un hook qui lance formatage et analyse statique après chaque édition. Ensuite, chaque erreur récurrente de l'agent devient un nouveau guide ou un nouveau contrôle.